
- 完了条件を1文書くと、条件を満たすまでAIがターンを回し続ける。
- customer-portalの4機能を逐次プロンプトなしで完走させた実行記録と、
- 評価器1回のコストを実測した数字をまとめる。
「続けて」の連打が地味にストレスだった。テストを書いて止まる、実行して失敗して止まる。長い実装ほど、このEnterを押す回数が増える。
/goalコマンドはこの往復を消す。完了条件を1文書くと、条件を満たすまでAIが自分でターンを回し続ける。customer-portalの生産パイプラインを設計工程まで広げる4機能を、逐次プロンプトなしで完走させた。
この記事は、その実行で分かった「効く条件の書き方」を軸に、設定から停止までの操作、評価器1回のコストを実測した数字、そして公式ドキュメントの記述と実際の挙動が食い違った箇所までをまとめる。
まず動かす:設定・確認・停止
/goalは引数で役割が変わる。条件を書けば設定、引数なしで状態確認、clearで停止。この3つを同じコマンドが受け持つ。セッションごとにアクティブなゴールは1つで、新しい条件を設定すると前のものが置き換わる。
条件を書いて設定する
/goalのあとに満たしたい条件を書く。
/goal ISSUES.md の #145 と #146 の見出し行を数えて結果を会話に示す or stop after 3 turns設定した瞬間にターンが始まる。条件そのものが指示として扱われるので、続けて別のプロンプトを送る必要はない。走っている間は画面に ◉ Goal active と実行時間が出る。
走っている間の状態を見る
引数なしで/goalを打つと、いまの状態が出る。
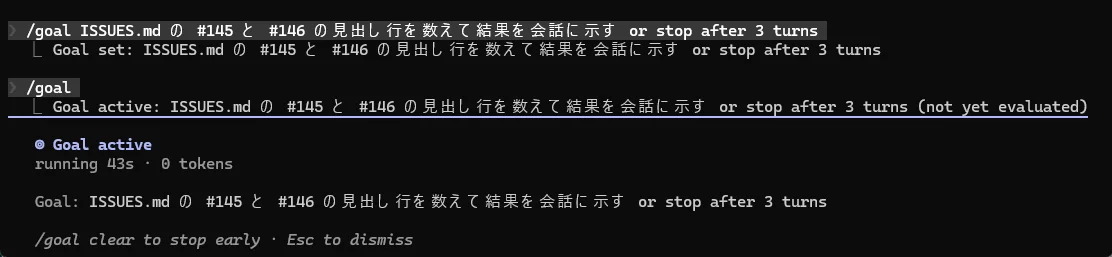
公式ドキュメントによれば、ここに出るのは5項目ある。条件、実行時間、評価されたターン数、現在のトークン支出、そして評価器が最後に返した理由だ。ただしターン数と理由は、最初の評価が走ったあとでないと出てこない。
ここで一度つまずいた。設定してすぐ引数なしの/goalを打ったら、返ってきたのは (not yet evaluated) で、上の画像のとおりトークンは0のまま。43秒動いていたのは時計だけだった。評価器はターンが終わったときに回るので、AIに仕事をさせないまま状態だけ覗いても何も出ない。
途中で止める
条件が満たされる前にやめたいときは /goal clear を打つ。stop off reset none cancel も同じ意味で受け付ける。/clear で会話を新しく始めた場合もゴールは消える。
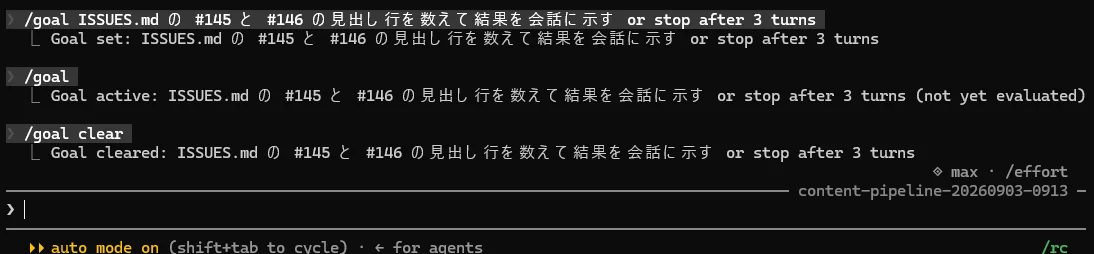
逆に、条件を満たしたときは自分でclearを打つ必要はない。ゴールは自動で解除される。実際、後述の検証で条件が満たされたあとに引数なしの/goalを打つと No goal set が返ってきた。止め忘れを気にしなくていい設計になっている。
セッションを閉じたあと
アクティブなまま終了したゴールは、セッションを再開すると復元される。公式ドキュメントは --continue、セッションIDや名前を指定した --resume、トランスクリプトのパス指定、セッションピッカーのいずれの経路でも戻ると書いている。ただし引き継がれるのは条件だけで、ターン数・タイマー・トークン支出の基準値はリセットされる。達成済みやclear済みのゴールは戻らない。
評価器は会話に出たものしか見ない
/goalの動作フロー:評価器が毎ターン完了判定するループ
/goalは完了条件をひとつ受け取り、その条件を満たすまでターンを自動で回す。Anthropicの/goalコマンド公式ドキュメントによると、各ターンが終わるたびに小さく速い評価モデル(既定はHaiku)が「条件は満たされたか」を判定する。未達ならその理由を次ターンへの指示として渡し、もう一度ターンを始める。条件が満たされた瞬間にゴールは自動で解除され、Claudeは通常モードに戻る。
graph TD
  A["ターン実行"] --> B["評価器が判定"]
  B -->|"未達 理由を渡す"| A
  B -->|"達成"| C["ゴール自動解除"]
  B -->|"打ち切り句"| D["停止"]
  style A fill:#e8eef6,stroke:#9fb3cc
  style C fill:#e8f3ec,stroke:#9ec7ad
  style D fill:#f3ece8,stroke:#c7b09e

筆者の実行では、途中で2回詰まった。1回目は"use server"ファイルでobjectをexportしてアクションが全滅したケース、2回目はagent-browserのclickがServer Actionを発火させなかったケース。どちらも/goalは「未達」と扱って継続させ、原因の特定から修正まで自走でやり切った。止まらず原因追及を続けるこの粘りが、人が「続けて」を打つ運用との一番の差だった。
判定は3つ。未達・達成・不可能
評価器が返す判定は3種類ある。まだ満たされていないならその理由が次のターンへの指示として渡り、Claudeは作業を続ける。満たされたならゴールが解除され、達成のエントリが記録される。そして不可能——条件を満たしようがないと評価器が判断した場合も、ゴールはクリアされて失敗エントリが残る。どの判定にも短い理由が付く。
3つ目を見落としていた。この記事の以前の版では「達成不能なら打ち切り句に当たるまで回り続ける」と書いていたが、公式ドキュメントを読み直すと不可能判定が出た時点で自動的にクリアされる。自分でclearする必要もない。回り続けるのは、条件が曖昧で評価器が「まだ」と言い続けるケースのほうだ。
判定理由の実物を取り出す
評価器が何を見て判断したかは、セッションのトランスクリプトに残る。軽い条件を1つ走らせて、その中身を取り出した。
met:        True
condition:  ISSUES.md の #145 と #146 の見出し行を数えて結果を会話に示す or stop after 3 turns
iterations: 1
durationMs: 49400
tokens:     2325
そして理由の全文がこれだ。
「ISSUES.md の #145 と #146 の見出し行を数えて結果を会話に示す」の条件が満たされた。アシスタントが Bash で grep と Python スクリプトを実行し、以下の結果を会話に表示した:#146 は L13 の 1 行、#145 は L81 の 1 行で、合計 2 行。表形式で見出し行の総数・行範囲・セクション内の行数・太字小見出し数の詳細も示した。条件の前半(数えて結果を会話に示す)は達成。ターン数は条件設定から本ターンで 1 ターンのため、”or stop after 3 turns” の後半にもまだ余裕がある。
読むべきは「会話に表示した」の一語だ。評価器はファイルを開いてもいないし、コマンドを叩き直してもいない。会話に出た内容だけを根拠に達成と判断している。後述する「検証結果を会話に出させる」一文が効く理由が、ここにそのまま書かれている。
条件の後半「or stop after 3 turns」まで評価器が数えていたのが意外だった。打ち切り句は飾りではなく、ちゃんと判定対象になっている。
評価器1回のコストを測った
公式ドキュメントは評価トークンについて「通常はメインターン支出と比べて無視できます」としか書いていない。具体的な数字がないので、上の実行で実測した。
| 項目 | 実測値 |
|---|---|
| 評価1回のトークン | 2,325 |
| 判定にかかった時間 | 49.4秒 |
| イテレーション | 1 |
条件文が短く、会話も1ターンぶんしかない状態での数字だ。評価器は条件と「これまでの会話」をまとめて受け取るので、セッションが長くなるほどこの値は上がると考えるのが自然だが、そこまでは測っていない。
本体ターンのほうは計測していない。体感で言えば、「続けて」連打は人が間に入る分だけ自然にペースが制御されるのに対し、/goalは入力を待たずに次のターンへ進むので消費が速い。気にすべきは評価器ではなく本体側だ。単価そのものを下げたいなら、Opus・Sonnet・Haikuを役割で分ける3層スタックでコストを半減させる手順が効く。
公式の記述と挙動が食い違った1箇所
検証中に、ドキュメントどおりに動かない箇所が1つ出た。公式は「ゴールがアクティブではないが、セッションの前半で達成された場合、ステータスは達成された条件とその期間、ターン数、およびトークン支出を表示します」と書いている。だが達成直後に引数なしの/goalを打つと、返ってきたのは No goal set. Usage: /goal <condition> だけだった。達成済みのステータスは出ていない。
上に載せた達成時の数値は、画面ではなくセッションのトランスクリプトから取り出したものだ。バージョン差の可能性もあるので断定はしないが、達成後に数字を確認したい場合は画面を当てにしないほうがいい。
完了条件の書き方:自走を成功させた実例
効いた条件の4要素
公式ドキュメントは、長いターン数を越えても崩れない条件の要素を挙げている。測定可能な終了状態、それをどう証明するかの手段、途中で壊してはいけない制約だ。筆者が実際に走らせて完走した条件は、これに打ち切り句を足した形だった。
/goal customer-portalの生産パイプラインを設計工程まで拡張する。
レビュー収束性・承認フロー・改訂自由指示・設計工程の横展開の4機能を実装し、
npx tsc --noEmit がエラー0で、各機能を実際にsupabaseで確認した結果を会話に示し、
既存機能を壊さないこと。 or stop after 60 turns
要素を分解すると、こうなる。
測定可能な終了状態:「tsc がエラー0」。会話に証拠(コマンド結果)が残る終了点。
証明する手段:「supabaseで確認した結果を会話に示す」。検証を強制する一文。
壊してはいけない制約:「既存機能を壊さない」。暴走の歯止め。
打ち切り句:「or stop after 60 turns」。上限を切ってループの底を作る。
条件は最長4,000文字まで書ける。短くまとめる必要はないので、終了状態・証明手段・制約を遠慮なく詰め込んでいい。
最重要は「検証結果を会話に出させる」一文
4要素のなかで決定的だったのは、「supabaseで確認した結果を会話に示す」の一文だ。評価器は会話に出た内容しか見ない。コマンドを自分で叩いたりファイルを読んだりはしない。公式も評価器について、Claudeが会話で表に出したものしか判定できないと明記している。
つまり「検証結果を会話に出させる」と書くことで、AI自身が検証ログを吐くよう仕向けられる。この一文がないと、AIは内部で「できたつもり」になっても、評価器にはそれが見えず判定が進まない。逆にこの一文があると、AIは証拠を会話に残しながら進むので、判定がきれいに通る。
「会話に出させる」を入れるか入れないかで、自走の安定感がまるで違った。評価器の目線で条件を書く、という発想が要る。
夜に仕込んで朝に見た2例目
4機能の実装とは別に、もう1本走らせている。こちらは寝る前に仕込んで朝に結果を見る使い方だった。
/goal customer-portal の docs/IMPROVEMENT_PLAN.md に従い、改善を T1→T9 の順で自走実装する。
トークンが尽きるまで進めてよい。
厳守: git commit しない(変更は作業ツリーに残す。朝に人がレビュー&コミットする)。1例目と違うのは2点。打ち切りをターン数ではなくトークンの枯渇に委ねていることと、制約のほうが主役になっていることだ。「git commitしない」は、公式が言う「その過程で変更されてはならないもの」にあたる。寝ている間に9個のタスクを進めさせるなら、どこまで進んだかを朝の自分が判断できる状態で止めてもらう必要がある。コミットまでされると差分が読めない。
終了状態を厳密に書けない作業でも、制約さえ効いていれば放置できる。1文に詰め込むのは終了条件だけではない。
主観条件が引き起こす「止まれないループ」
逆に入れてはいけないのが主観条件だ。筆者は「UXを良くする」のような条件は最初から外した。評価器が良し悪しを測れないからだ。
公式が挙げる典型的な失敗例も「本番運用に耐える品質(production-ready)」型の条件で、検証可能な出力を生まないため達成判定が出ない。条件が甘すぎれば早すぎる解除になり、逆に測れない条件は「まだ」と言われ続ける。会話に証拠が出る客観条件だけが機能する–これは実際に走らせて骨身にしみた。
/goal・/loop・Stop hook・auto modeの境界
セッションを止めずに走らせ続ける仕組みは、/goalだけではない。公式ドキュメントは3つを並べて比較している。「次のターンが何をきっかけに始まるか」で選ぶ。
| 次のターンが始まるきっかけ | 止まるとき | |
|---|---|---|
| /goal | 前のターンが終わったとき | 条件が満たされた/不可能と判断された/修正が必要なエラーでターンが失敗した//goal clear |
| /loop | 時間間隔が経過したとき | 自分で止めるか、Claudeが作業完了と判断したとき |
| Stop hook | 前のターンが終わったとき | 自分で書いたスクリプトまたはプロンプトが判断する |
/goalとStop hookはどちらも毎ターン後に走る。違いは寿命と範囲で、/goalはセッション限りのショートカット、Stop hookは設定ファイルに常駐してそのスコープの全セッションに効く。実際、/goalの中身はセッションスコープのStop hookのラッパーだ。だからフックのガイドが示す仕組みが動く環境でないと使えない。
/loopについては、この記事の以前の版で「一定間隔で同じプロンプトを再実行する」とだけ書いていた。間隔を省くとClaudeが毎回自分で間隔を決める動的モードも使えるようになっていて、停止条件も「自分で止める」だけではない。時間で起こすなら/loop、終わりが条件で決まるなら/goal、という切り分け自体は変わらないが、/loop側は説明した当時より広くなっている。
auto modeとは競合しない。むしろ併用する
紛らわしいのがauto modeとの関係だが、これは別の層を担当している。auto modeが消すのはツール1回ごとの承認で、新しいターンは始めない。/goalが消すのはターンごとのプロンプトだ。公式も「この2つは相互に補完的」と書いている。
重要なのは、ゴールを設定しても権限モードは変わらないという点。手動モードのまま/goalを走らせると、設定で許可していないツール呼び出しのたびにClaudeが確認を求めてくる。せっかく自走させても、結局そこで止まる。筆者はauto modeを常用しているので気付きにくかったが、無人で回したいなら両方が要る。
止まる・消える・動かないの切り分け
自走が途切れたとき、原因は「ゴールが消えた」「ループが止まった」「そもそも使えない」の3つに分かれる。出方が違うので、先に知っておくと迷わない。
直さないと復旧しないエラーはゴールごと消える
ターンが失敗したとき、その原因が自分で直すまで解消しない種類なら、Claude Codeはゴールをクリアして警告を出す。公式が挙げているのは4つ。認証の失敗、クレジット残高の枯渇、自動コンパクションでも解消できないコンテキスト溢れ、そしてモデルが利用できない場合だ。
警告は Goal cleared after an unrecoverable error で始まり Run /goal again to continue で終わる。原因を直してから条件を設定し直す。レート制限やサーバー過負荷のような一時的なエラーでは消えない。
進捗が止まるとループ自体が降りる
評価器に答え続けているのに前へ進んでいない場合——具体的には複数ターン連続でツールを1つも使っていない場合——Claude Codeはループを止め、警告を出して制御を戻す。ゴールは設定されたまま残り、次にこちらがプロンプトを送れば評価が再開する。無限に空回りしない歯止めが入っている。
バックグラウンド作業があると評価が後ろにずれる
サブエージェントやバックグラウンドのシェルコマンドがターン終了時にまだ走っていると、そのターンの評価はスキップされる。裏の作業が終わった状態で終わる次のターンで評価される。
待たされ続けた場合に備えて、公式は30分でチェックインが入る仕組みを用意している。実行中のタスクを並べ、出力を読ませ、進んでいるなら待機を続け、詰まっているものは直すか止めるようClaudeに求める。以降の間隔は2倍ずつ伸び、最初の4倍が上限。CLAUDE_CODE_GOAL_CHECKIN_MINUTES で最初の間隔を変えられて、0にすれば切れる。
ここは筆者の実体験ではない。この仕組みが入ったのはv2.1.234で、筆者が4機能を走らせたときのバージョンはv2.1.158から2.1.167だった。当時は存在しない機能なので、挙動の細部は手元で確認してほしい。
コマンド自体が使えないときは、フックが止められている
/goalの実体がStop hookである以上、フックが動かない環境では使えない。まず信頼ダイアログを承認したワークスペースであること。そのうえで、設定の優先順位を適用した結果 disableAllHooks が有効になっている場合と、管理設定で allowManagedHooksOnly が指定されている場合は、どちらもフックごと無効になる。会社やチームのアカウントで反応しないなら、まずこの2つを疑う。なお disableAllHooks は、2026年10月に入ったModsも、自分で入れたものはまとめて止める。課金スクリプトを止めるModを作った記録で使った仕組みも、この設定では動かない。
いずれの場合もコマンドは黙って何もしないのではなく理由を表示する。無反応で悩むことはない。
今日から始める/goal活用ステップ
副業開発で試すなら、いきなり大物に当てず、小さく回して感覚を掴むのが近道だ。
- STEP1連打タスクを1つ選ぶ
今「続けて」を繰り返しているタスクを1つ特定する。テストを通すまで、リファクタが終わるまで、といった「終わりが言える」作業が向く。
- STEP2完了条件を1文で書く
終了状態・証明手段・制約・打ち切り句を1文に詰める。とくに「結果を会話に示す」を入れて、AIに証拠を吐かせる。これが効く条件の核心。
- STEP3小さく走らせて消費を見る
短い作業で走らせ、引数なしの/goalでターン数とトークン消費を確認する。自走のペース感を体で覚えてから、大きいタスクに広げる。
よくある質問
- Q/goalは普通のClaude Codeと何が違いますか?
- A
通常はAIが1ターンごとに止まり、人が「続けて」と打ち直す。/goalは完了条件を満たすまでAIが自分でターンを回し続ける。各ターンの後ろで小さな評価器が条件を満たしたか判定し、未達なら自動で次のターンに入る。人がEnterを押す回数がゼロになるのが最大の違い。
- Q自走中にトークンを使いすぎませんか?
- A
人が間に入らない分ターンが連続するので、消費は短時間で速く進む。引数なしの/goalを打てば、その時点のターン数とトークン消費が出るので途中で確認できる。条件末尾に「or stop after 60 turns」のような打ち切り句を入れておけば暴走は防げる。判定役の評価器は実測で1回2,325トークンだった。本体ターンに比べれば誤差の範囲になる。
- Qどんな完了条件だと失敗しますか?
- A
「本番運用に耐える品質」のような主観的な条件は失敗する。判定する評価器は会話に出た内容しか見ないので、良し悪しを測れない条件は達成判定が出ない。「npm testがエラー0」「git statusがクリーン」のように、AIの出力に証拠が残る客観的な終了状態を書くこと。
- Q法人アカウントで/goalが使えないのはなぜですか?
- A
/goalはフックシステムを使って動く。会社のmanaged policyでdisableAllHooksが設定されていると、フックごと無効になり/goalも使えない。また信頼ダイアログを承認していないワークスペースでも動かない。どちらの場合もコマンドが理由を表示するので、無反応で悩むことはない。
- Q/loopとはどう使い分けますか?
- A
/goalは「条件を満たしたら止まる」完了駆動。/loopは「一定間隔で同じプロンプトを再実行する」時間駆動で、夜間テストや定期チェックに向く。終わりが条件で決まる作業は/goal、決まった間隔で回したい作業は/loop、と分けると迷わない。
終わりを1文で書けたなら、その仕事はもう渡せる
/goalを実際に走らせて分かったことは3つだった。
ひとつ、完了条件を1文書くだけで、AIは詰まっても止まらず条件を満たすまで自走する。ふたつ、効く条件の核心は「検証結果を会話に出させる」一文で、評価器は会話しか見ないからここが決定的になる。判定理由を取り出したら、そこにも「会話に表示した」と書いてあった。みっつ、客観的に検証できる終了状態か、朝の自分が読める形で止まる制約か、どちらかが要る。主観条件だけでは評価器が判断できない。
コストの心配はしなくていい。評価器1回は2,325トークン・49.4秒で、本体ターンに比べれば誤差だ。むしろ気をつけるのは、人が間に入らない分だけ本体側の消費が速く進むほうになる。
まず手元で「続けて」を連打しているタスクを1つ選び、終わりを1文で書いてみる。書けたなら、その仕事はもうAIに渡せる。書けないなら、自分の中でゴールがまだ曖昧だというサインだ。/goalは、その曖昧さを毎回突きつけてくる道具でもある。

